在结构方程模型(SEM)中,潜变量(Latent Variables)的选取是构建理论模型的核心环节。潜变量通常代表抽象的构念(如满意度、忠诚度),无法直接测量,必须通过显变量(Observed Variables)或指标来间接反映。选取过程需严格遵循理论驱动原则,结合文献综述与心理测量学标准,以确保模型的科学性与有效性。
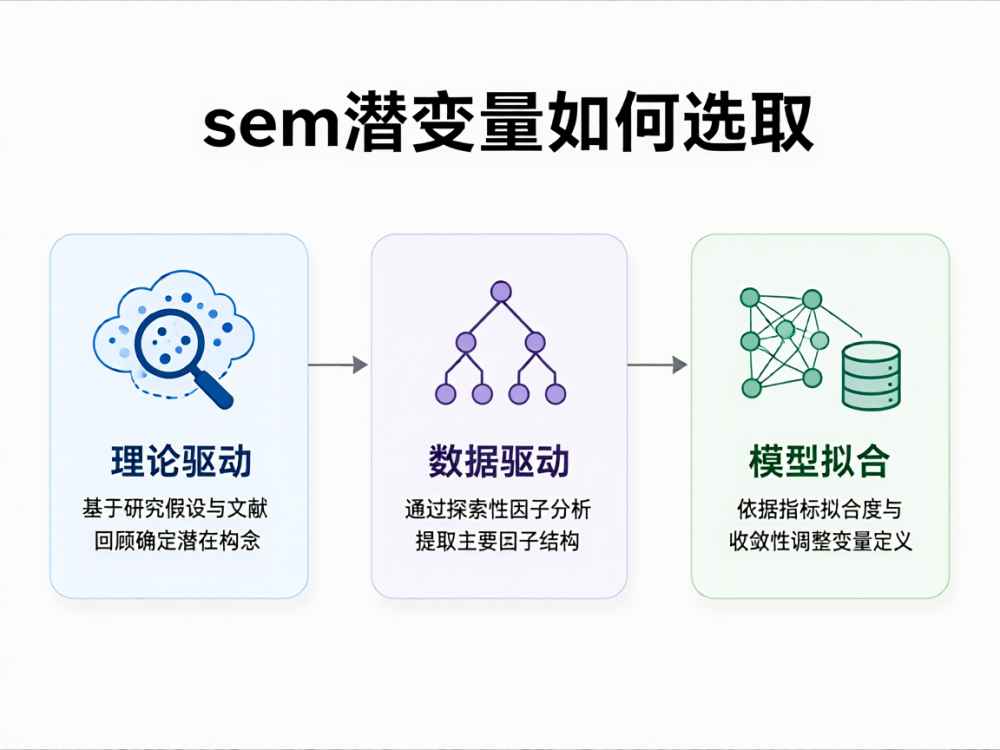
首先,潜变量的设定必须基于成熟理论基础。研究者需明确研究中的核心概念,确保所选潜变量能够解释变量间的因果关系。例如,若研究基于技术接受模型(TAM),则应选取“感知有用性”和“感知易用性”作为潜变量。这一步决定了模型的概念框架,严禁仅凭数据相关性随意设定变量,否则会导致内生性问题。
其次,需明确潜变量的指标类型,主要分为反映型(Reflective)和形成型(Formative)。反映型潜变量由显变量推导而出,显变量之间通常存在正相关且可互换(如满意度评分)。形成型潜变量由显变量组合而成,显变量间无需相关且不可互换(如人口统计学特征)。选取时需根据构念定义判断:若显变量是潜变量的症状,选反映型;若是原因,选形成型。混淆二者会导致模型设定错误及路径系数偏差。
在确定潜变量类型后,需筛选具体的测量指标(Indicators)。通常采用文献回顾法,选取前人验证过的量表(Scale),并确保指标涵盖潜变量的所有维度。同时,指标数量一般建议为每个潜变量设置3 至 4 个,过少会导致估计不精确,过多则可能引入测量误差。若需自行开发量表,应通过专家评定和预测试来筛选条目,确保内容效度。
最后,选取后的潜变量需通过统计检验验证其质量。关键指标包括聚合效度(Convergent Validity)和区分效度(Discriminant Validity)。具体标准为:因子载荷(Factor Loadings)需大于 0.7,平均方差提取量(AVE)需大于 0.5,组合信度(CR)需大于 0.7。若统计结果不达标,需重新审视指标选取,必要时删除低载荷指标或调整模型结构。
常见的错误包括过度依赖数据驱动而非理论驱动,或忽视潜变量之间的共线性。正确的选取流程应为:理论建构 -> 指标确定 -> 量表验证 -> 统计检验。唯有遵循严谨的方法论,才能确保 SEM 分析结果的内部效度与外部效度,使研究结论具有说服力。
查看详情
查看详情