网页系统自动查找数据是现代互联网应用中的核心功能之一,其本质是通过程序化方式从数据源中自动检索、筛选和提取用户所需的信息。该过程通常涉及前端交互、后端处理、数据库查询以及外部数据源对接等多个技术环节,能够实现实时性、精准性和智能化的数据获取。
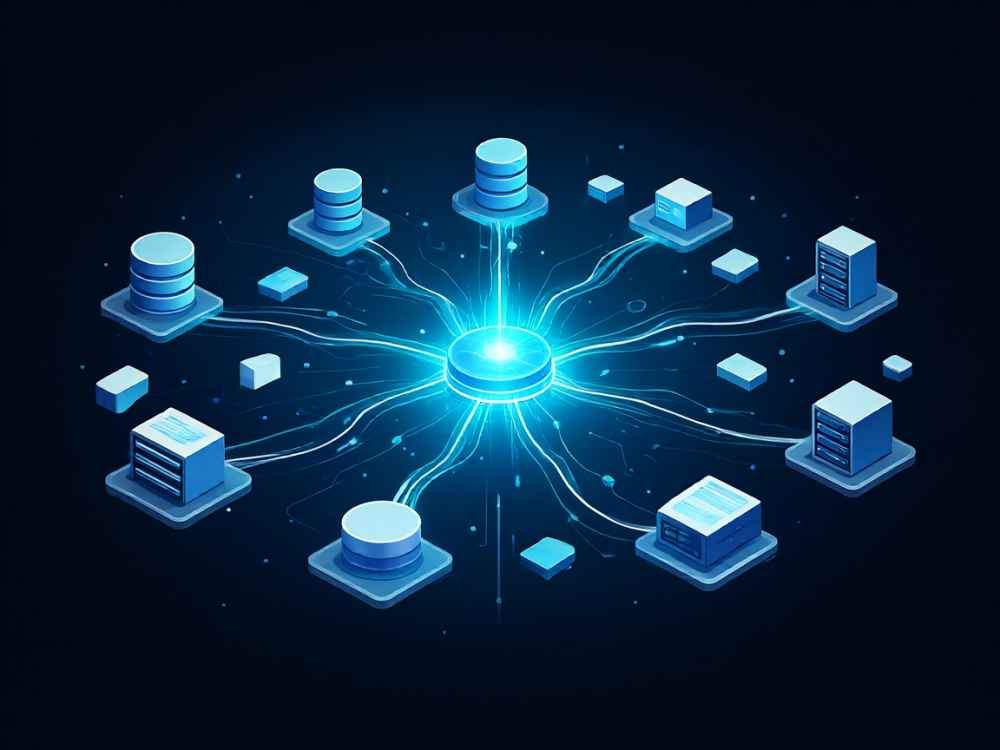
从技术架构来看,网页系统自动查找数据的实现主要依赖客户端-服务器模型。前端通过JavaScript中的Fetch API或XMLHttpRequest发送异步请求,后端接收请求后调用数据库查询语句(如SQL)或搜索引擎接口(如Elasticsearch)执行数据检索,最后将结果以JSON或XML格式返回前端进行渲染。
在前端实现方面,异步数据加载是自动查找的关键技术。通过AJAX技术,网页可以在不刷新页面的情况下向服务器发送请求并接收响应,结合DOM操作动态更新页面内容,从而提升用户体验。现代框架如React、Vue.js和Angular进一步封装了这些过程,提供了响应式数据绑定和组件化开发,使数据查找更加高效和可控。
在后端实现方面,数据查找依赖于数据库管理系统和搜索引擎技术。关系型数据库(如MySQL、PostgreSQL)使用索引优化和查询执行计划加速检索;NoSQL数据库(如MongoDB)则通过文档结构和分片技术实现海量数据的快速查询。对于全文检索场景,Elasticsearch等分布式搜索引擎通过倒排索引和分词技术实现毫秒级响应。
对于外部数据源的自动查找,网络爬虫(Web Crawler)是最常用的技术方案。爬虫程序通过HTTP协议访问目标网页,使用HTML解析器(如BeautifulSoup、lxml)或浏览器自动化工具(如Selenium、Playwright)提取数据,再经过数据清洗和去重处理存入数据库。此外,API接口对接也是常见方式,系统通过RESTful API或GraphQL与第三方服务通信,获取结构化数据。
在智能化和自动化方面,现代网页系统开始引入人工智能技术来增强数据查找能力。自然语言处理(NLP)可以解析用户的模糊查询意图,将其转换为结构化检索条件;机器学习算法能够基于用户行为数据进行个性化推荐,自动呈现最相关的结果。知识图谱技术则通过实体关系和语义网络,实现深层关联数据的智能发现。
在性能优化方面,网页系统自动查找数据需要关注多个维度。缓存机制(如Redis)能够减少重复查询的数据库压力;分页加载(Pagination)和虚拟滚动(Virtual Scrolling)可以优化大数据量下的前端渲染性能;索引优化和查询语句优化则能显著提升数据库检索速度。此外,CDN加速和负载均衡可提升系统的整体响应能力。
在安全性方面,自动查找数据功能需要防范SQL注入、XSS跨站脚本攻击和CSRF跨站请求伪造等安全威胁。开发人员应采用参数化查询、输入验证和输出编码等防护措施,同时合理控制查询频率和访问权限,防止恶意用户利用自动查找功能进行数据爬取或资源滥用。
在实际应用中,网页系统自动查找数据广泛用于电子商务(商品搜索与推荐)、新闻聚合(实时资讯抓取)、企业管理系统(业务数据检索)、搜索引擎(关键词匹配)以及数据分析平台(多维数据过滤)等场景。随着大数据和云计算技术的发展,该系统正朝着分布式、高并发、智能化方向持续演进,为企业决策和用户服务提供更加高效的数据支撑。
综上所述,网页系统自动查找数据是一个综合性技术工程,涉及前后端协作、数据库设计、网络通信、算法优化和安全防护等多个层面。开发者需要根据业务需求和数据规模,合理选择技术栈和架构方案,在准确性、实时性和性能之间找到最佳平衡点。
查看详情
查看详情