要真正理解万能的搜索引擎,首先需要明确一个核心认知:搜索引擎不是答案的提供者,而是信息索引的入口。它的底层逻辑是爬虫抓取与倒排索引,即预先将全网公开网页进行词项映射。因此,“万能”并非指它能回答任何问题,而是指它能帮你精准定位你认知边界内的任何公开信息。掌握它的使用,本质上是掌握一套信息检索的认知方法论。
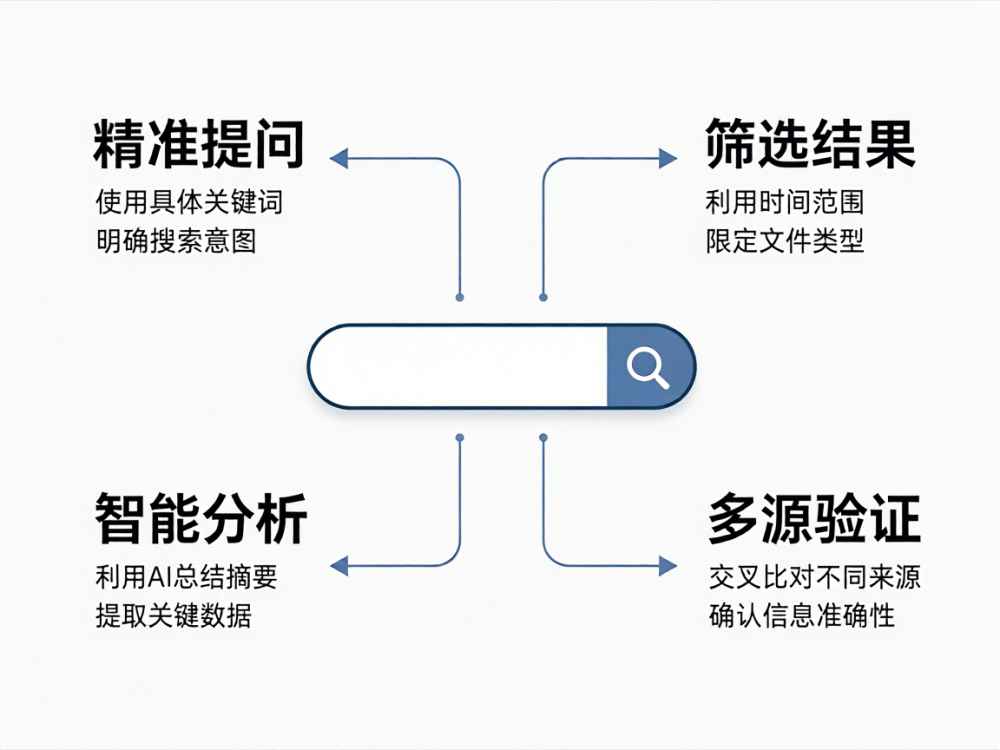
要构建一个“万能”的搜索策略,必须先从查询构造开始。大多数低效搜索源于关键词模糊。专业的查询应遵循特定性优先原则:先输入能唯一标识目标信息的名词,而非泛泛的形容词或动词。例如,搜索“苹果 公司 市值 2025”远优于“苹果怎么样”。此外,善用布尔逻辑是入门第一课:AND用于强制包含,OR用于扩大范围,NOT用于排除噪音。在主流搜索引擎中,减号与引号是布尔逻辑的快捷实现,例如“量子纠缠” -科普可过滤掉科普类结果,而“信息检索系统”可强制精确匹配短语,避免被拆词。
真正让搜索“万能”的,是掌握高级操作符的精确制导能力。这些操作符是搜索引擎内置的元数据过滤器,能穿透表层网页直达核心信息源。例如:site:域名用于限定来源,filetype:pdf用于锁定文档格式,intitle:与inurl:用于匹配标题或网址中的关键词,related:网址用于发现同类站点,before:日期与after:日期用于限定时间窗口。将这些操作符组合使用,可以构建出超精准的查询表达式,例如site:arxiv.org filetype:pdf “transformer” “attention is all you need”,能秒级定位到原始论文。
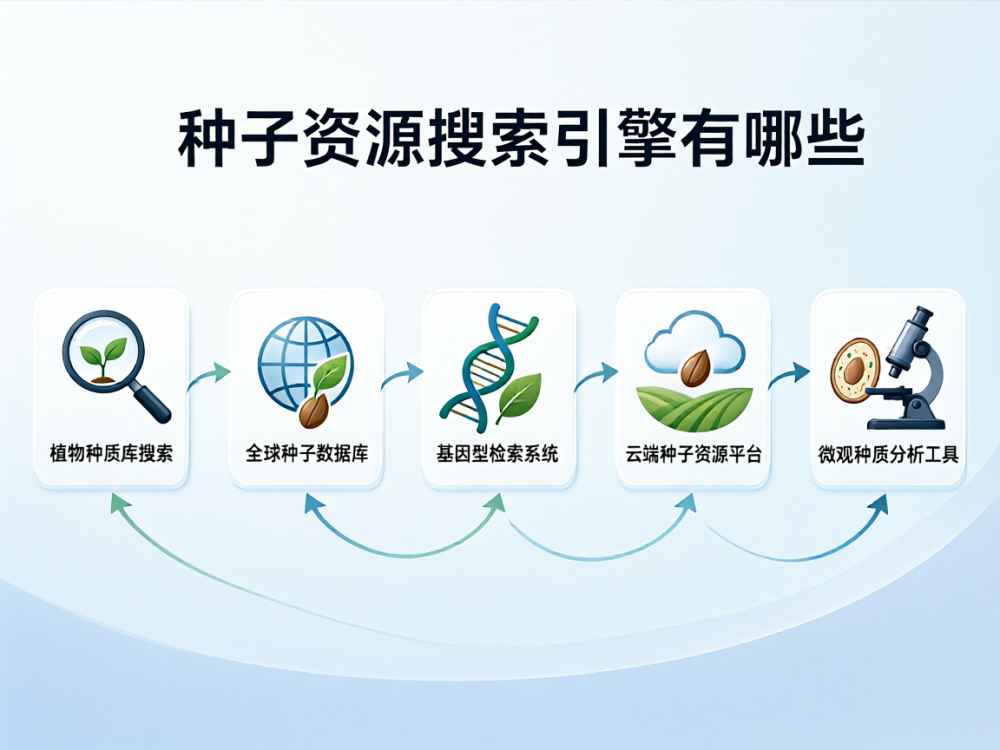
但在搜索之前,必须明确搜索域的划分。万能搜索的关键不是“怎么搜”,而是在哪搜。通用搜索引擎(如Google、Bing)擅长覆盖广泛网页,但面对学术文献、统计数据、代码仓库或专业论坛时,应直接切换到垂直搜索引擎。例如,学术检索应使用Google Scholar或Semantic Scholar,代码检索应使用GitHub Code Search,学术统计应使用Statista或国家统计局。将通用引擎视为信息世界的导航台,将垂直引擎视为专业领域的档案馆,才是“万能”的真正内涵。
搜索结果的可信度评估是专业使用者必须建立的第二道防线。面对搜索结果,绝不能只阅读第一条或首屏内容。专业策略是执行三角验证:对同一信息,至少从三个独立、权威、不同域名的来源进行交叉确认。评估权威性时,应优先信任政府域名(.gov)、教育机构(.edu)、行业白皮书以及高被引学术论文。对于时效性信息,应利用时间过滤确保数据未过期;对于技术性信息,应查看原始文档而非二手解读。这种批判性阅读是区分信息与噪音的关键。
高效搜索的终极技巧,是掌握迭代式搜索(Iterative Search)与反向工程。初次搜索结果往往只是线索,而非答案。专业的做法是:第一轮搜索定位权威来源;第二轮使用site:操作符进入该来源内部,配合关键词变体深挖;第三轮利用参考文献或相关链接进行横向溯源。同时,善用图像识别搜索(如Google Lens)与语音搜索可以突破文字局限。当搜索陷入僵局时,应逆向思考:用“怎么不”“错误”“失败”等反向词搜索,往往能通过发现问题来定位正确路径。
最后,必须清醒认识到搜索引擎的边界。它只能索引公开可抓取的内容,对于深网(如需要登录的数据库、动态生成的API数据)、私有知识库以及实时对话信息,搜索引擎是无效的。因此,“万能”的真正含义是:在正确的时间、正确的地点,使用正确的工具和操作符,对公开信息进行系统性重构。当你能够熟练运用以上原理时,搜索引擎便不再是简单的查询框,而是一个可编程的信息获取接口,其威力将远超你的想象。
查看详情
查看详情