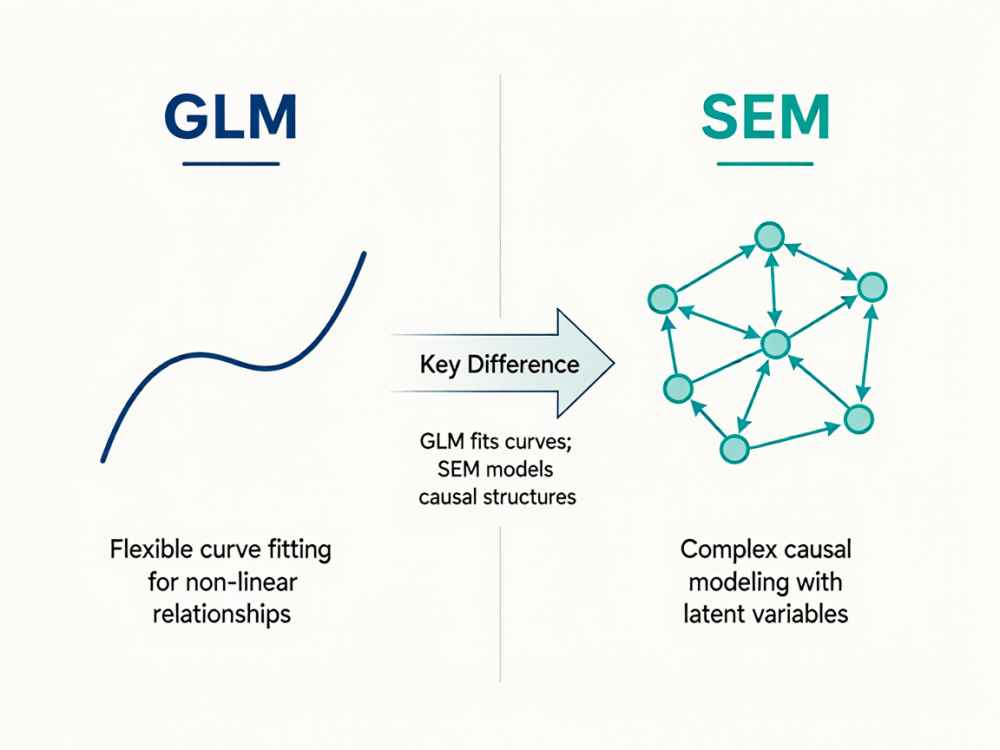
广义线性模型(GLM)和结构方程模型(SEM)是统计学中两个截然不同但相互关联的建模框架,它们在理论基础、模型结构、变量处理方式、估计方法和应用目的等方面存在本质区别。
一、理论基础与历史渊源
GLM由Nelder和Wedderburn于1972年提出,是对经典线性回归模型的推广。其核心思想是将响应变量的分布假设从正态分布扩展到指数分布族,并通过链接函数将线性预测器与响应变量的期望值关联起来。GLM的数学基础建立在极大似然估计和迭代加权最小二乘法之上,是经典统计理论的重要组成部分。
SEM则起源于20世纪70年代,融合了因子分析和路径分析两大技术,其理论基础是协方差结构分析。SEM的核心思想是通过样本协方差矩阵与模型隐含协方差矩阵的拟合来验证理论模型,属于多变量统计分析的范畴,更强调变量间因果关系的推断和理论模型的验证。
二、模型结构的根本差异
GLM是单一方程模型,其形式为:g(μ) = Xβ,其中g是链接函数,μ是响应变量的期望值,X是设计矩阵,β是参数向量。GLM只描述一个响应变量与多个预测变量之间的关系,即使采用多元GLM,也只是对不同响应变量分别建模,缺乏变量间的同时性和互依性分析。
SEM则是多方程联立模型,包含测量模型(潜变量与观测变量之间的关系)和结构模型(潜变量之间的因果关系)两个部分。SEM可以同时处理多个内生变量、多个外生变量以及潜变量,能够建立复杂的路径关系和中介效应模型。
三、变量处理方式的核心区别
GLM直接处理可观测变量,假设所有变量均无测量误差。GLM中的自变量和因变量都是直接观测到的数据,不考虑潜在构念或测量误差的存在。这在社会科学、心理学等领域是一个显著的局限,因为许多概念(如智力、幸福感、态度等)无法直接测量。
SEM可以同时处理潜变量和观测变量。潜变量是理论上存在但无法直接测量的概念,通过多个观测指标间接测量。SEM通过因子分析的框架,能够分离测量误差与结构误差,从而更准确地估计变量间的真实关系。这是SEM在行为科学和心理学中广泛使用的主要原因。
四、估计方法的差异
GLM通常采用极大似然估计(MLE)或拟极大似然估计(QMLE)来估计参数。对于不同分布族的响应变量,GLM利用迭代加权最小二乘法(IRLS)求解参数,其估计理论相对成熟,计算效率高,适用于大数据集。
SEM的估计方法更为多样,包括极大似然估计、广义最小二乘法、加权最小二乘法、贝叶斯估计以及非参数估计等。SEM估计的目标是最小化样本协方差矩阵与模型隐含协方差矩阵之间的差异,通常需要迭代优化过程。SEM对样本量的要求较高,一般建议样本量至少为观测变量的5-10倍。
五、应用场景与目的的根本不同
GLM的核心应用目标是预测和关联性分析。当研究者希望预测一个响应变量的值,或检验某个预测变量对响应变量的边际效应时,GLM是最合适的选择。GLM广泛应用于流行病学、临床试验、生物统计、计量经济学等领域,例如:逻辑回归用于疾病风险预测,泊松回归用于计数数据分析。
SEM的核心应用目标是理论验证和因果推断。当研究者希望验证某个理论模型是否与观测数据吻合,或检验复杂的中介效应和调节效应时,SEM是首选工具。SEM广泛应用于心理学、社会学、教育学、组织行为学等领域,例如:验证智力的多因素结构模型,检验工作满意度对绩效的路径关系。
六、模型拟合评价的差异
GLM的拟合优度评价主要基于偏差分析、似然比检验和AIC/BIC等信息准则。研究者通过比较全模型与零模型的偏差变化来评估模型的解释能力,并通过残差分析检验模型假设是否满足。
SEM的拟合优度评价则包含绝对拟合指数(如χ²、RMSEA、GFI、SRMR)、相对拟合指数(如CFI、TLI、NFI)和信息准则(如AIC、BIC)等多维度指标。SEM需要从整体模型拟合、测量模型拟合和结构模型拟合三个层面进行综合评价,评价体系更为复杂和全面。
七、模型扩展方向的差异
GLM的扩展方向包括:广义估计方程(GEE)用于处理纵向数据和相关观测;广义可加模型(GAM)用于处理非线性关系;混合效应GLM(GLMM)用于处理随机效应和分层结构。
SEM的扩展方向包括:多组SEM用于跨组测量不变性检验;多层SEM(MSEM)用于处理嵌套数据结构;纵向SEM用于潜在增长曲线模型;贝叶斯SEM用于处理小样本和复杂模型。
八、总结性比较
概括而言,GLM和SEM在统计建模中扮演着互补的角色。GLM是灵活的回归框架,擅长处理非正态响应变量,在预测和关联分析方面功能强大;SEM是结构化的路径框架,擅长处理潜变量和因果系统,在理论验证和复杂效应分解方面独具优势。选择哪种模型取决于研究问题、数据结构和理论框架,两者并非互斥,在某些场景下甚至可以结合使用(例如,在SEM的结构方程中采用广义线性建模技术)。
查看详情
查看详情